ChatGPTやPerplexityの検索に出たいなら、まず各社の検索用のクローラーを止めていないかを確かめます。
クローラーは、ページを自動で回って集めるプログラムで、読みに来てよいかはrobots.txtというファイルで伝えます。
AIの検索に読んでもらうための対策は、特別なことではありません。
「ChatGPTに、うちの会社を紹介してもらうには」と気になっていませんか。
AIの対策と聞くと、新しく何か始めなければと焦りますよね。
この記事では、各社の公式のページをもとに、AIのクローラーとrobots.txtの関係をまとめました。
各社の説明は変わることがあるので、2026年10月19日に確かめた内容として書いています。
- 「ChatGPT SEO」の2つの意味と、この記事で扱うこと
- 検索用・学習用など、AIのクローラーの役目の違い
- ChatGPT・Perplexity・Google・Copilotの公式の説明
- robots.txtの確かめ方・書き方の例と、気をつけること
《この記事を書いた人》
吉村浩平(アプリコットフィルム
Web集客の
これまで
自社でも
開始半年で
記事は、
ChatGPTのSEOとは?AIの検索に読んでもらうこと
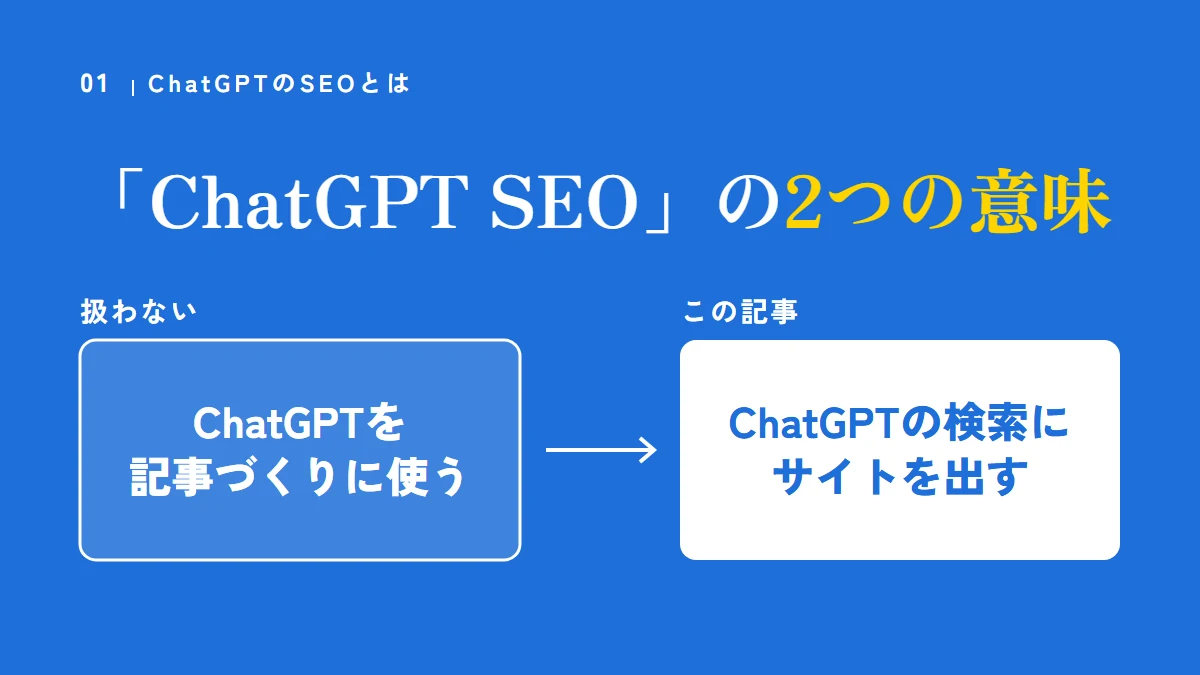
「ChatGPT SEO」には、記事づくりにChatGPTを使う話と、ChatGPTの検索にサイトを出す話の2つがあります。
この記事は、ChatGPTなどのAIの検索に、自社のサイトを読んでもらう話です。
2つの意味を分けておけば、調べるものをまちがえません。
「ChatGPT SEO」で調べて、記事の書き方ばかり出てきて戸惑いませんでしたか。
「ChatGPT SEO」という言葉には、2つの意味があります。
| 意味 | 中身 | この記事 |
|---|---|---|
| ChatGPTを記事づくりに使う | 見出しや文章の案を出してもらう | 扱わない |
| ChatGPTの検索にサイトを出す | ChatGPTなどのAIの検索に、自社のサイトを読んでもらう | 扱う |
AIの検索も、まずページを読みに来る
ChatGPTやPerplexityの検索で、答えの材料になるページを集めに来るのが、クローラーです。
OpenAIは、検索用のクローラーを止めたサイトは、ChatGPTの検索の答えに出ないと説明しています。
読みに来てよいかは、robots.txtで伝える
robots.txtは、サイトの一番上の階層に置く、決まった名前のテキストファイルです。
Googleは、robots.txtを、クローラーにサイトのどのURLにアクセスしてよいかを伝えるもの、と説明しています。
OpenAIとPerplexityも、クローラーの扱いをrobots.txtで決めるよう案内しています。
出典:Google 検索セントラル『robots.txt の概要とガイド』(2025年12月更新・2026年10月19日に確認)
ChatGPTの検索に出るには、記事をChatGPTで書く必要があるんですか。
いいえ、2つは別の話です。
ChatGPTの検索に出るかどうかで、まず確かめるのは、検索用のクローラーを止めていないかです。
AIのクローラーは、役目で分かれる
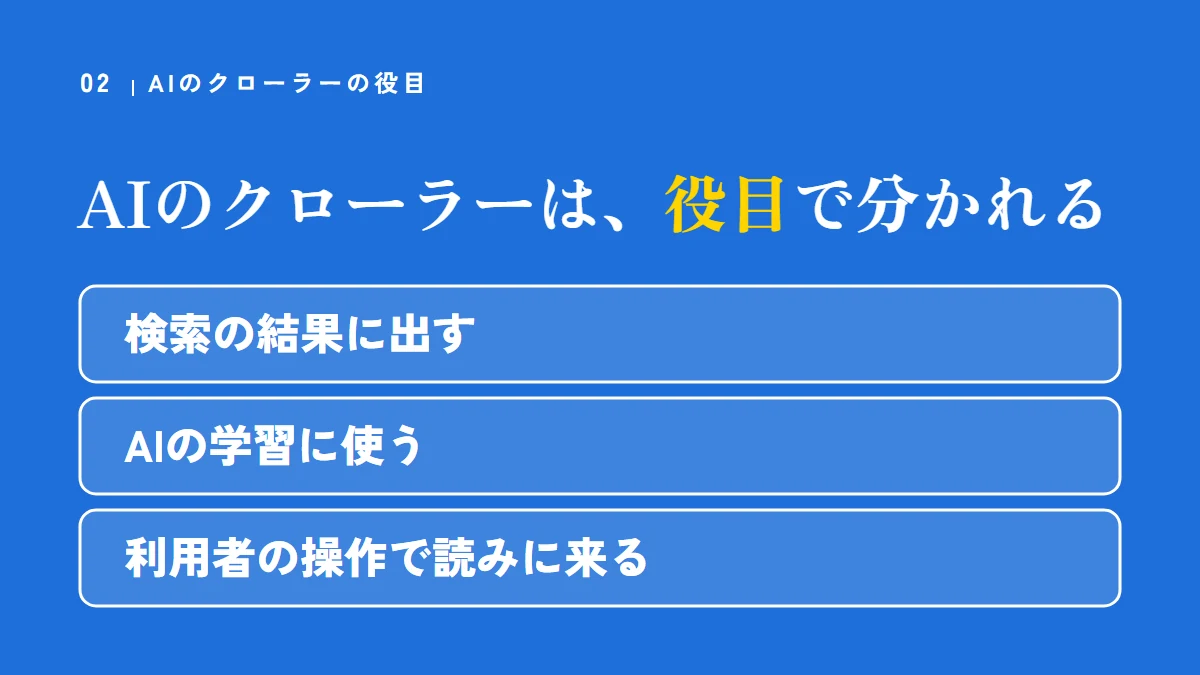
AIの会社のクローラーには、検索の結果に出すためのものと、AIの学習などに使うためのものがあります。
利用者の操作で訪れるものもあり、それぞれ別に扱います。
役目の違いが分かれば、止めてよいものを選べます。
「AIのクローラーは、全部止めたほうが安全?」と迷いますよね。
各社の公式の説明では、クローラーは役目ごとに名前が分かれています。
| 名前 | 会社 | 役目 |
|---|---|---|
| OAI-SearchBot | OpenAI | ChatGPTの検索の結果に出す |
| GPTBot | OpenAI | AIのモデルの学習に使う |
| ChatGPT-User | OpenAI | 利用者の操作で読みに来る |
| PerplexityBot | Perplexity | Perplexityの検索の結果に出す |
| Perplexity-User | Perplexity | 利用者の質問で読みに来る |
| Googlebot | Google検索のクロール | |
| Google-Extended | Geminiの学習などに使わせるか | |
| Bingbot | Microsoft | Bingのふだんのクローラー |
※2026年10月19日に、各社の公式のページで確かめた内容です。
各社の説明は変わることがあります。
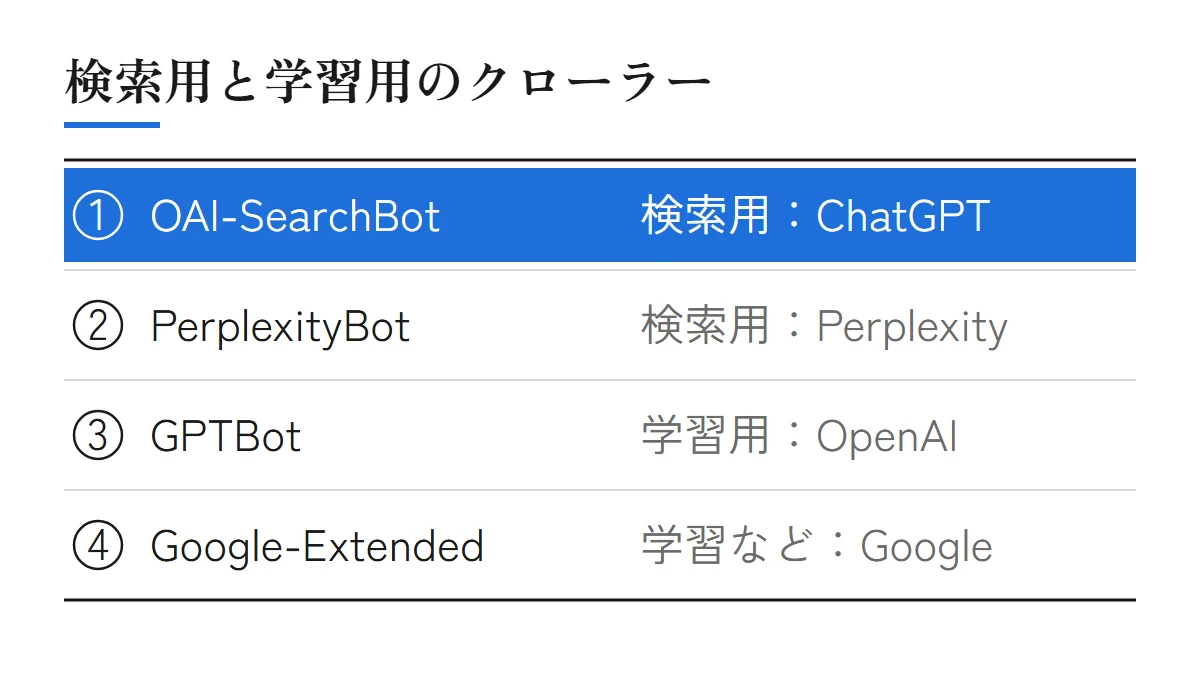
検索用と学習用は、別に決められる
OpenAIは、設定はそれぞれ別だと説明しています。
たとえば、OAI-SearchBotを許可して検索の結果に出しながら、GPTBotを止めることができます。
つまり、「学習には使わせないが、検索には出したい」という分け方ができます。
ChatGPTとPerplexity:検索用のクローラーを止めない
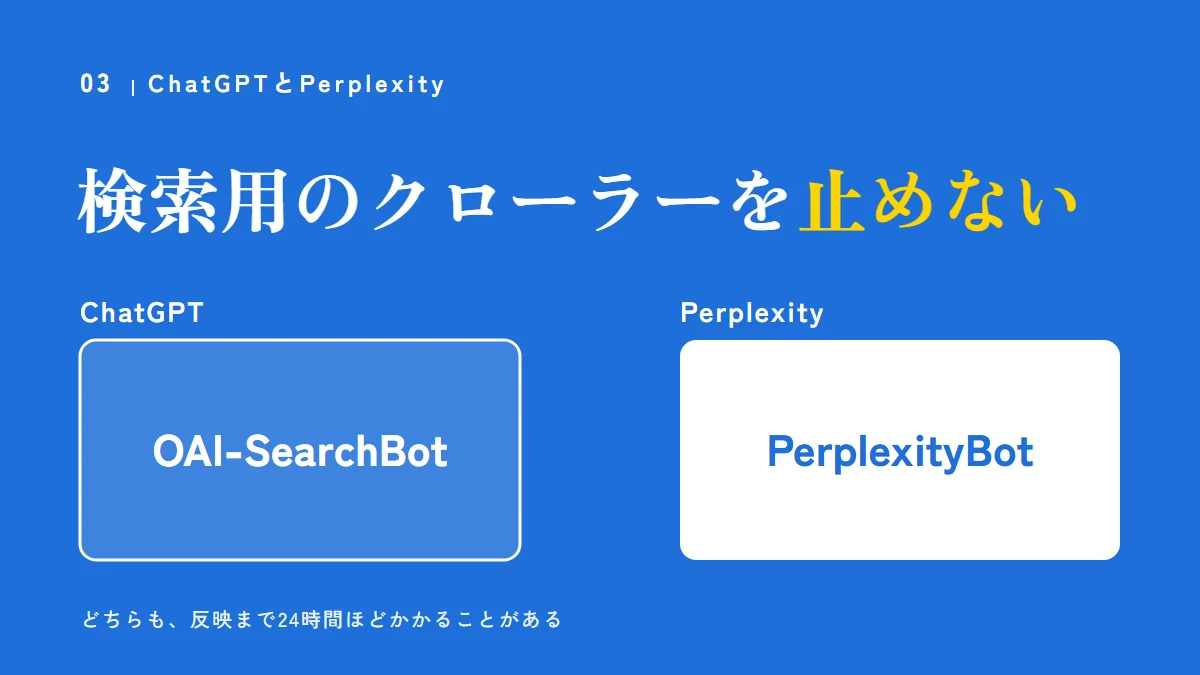
ChatGPTの検索に出したいならOAI-SearchBot、Perplexityの検索に出したいならPerplexityBotを、robots.txtで止めないようにします。
どちらも、反映まで24時間ほどかかることがあります。
2社の説明を知れば、確かめる名前は2つに絞れます。
「ChatGPTとPerplexity、両方の対策なんて大変そう」と思いますよね。
実は、2社とも同じ考え方で説明しています。
OpenAI(ChatGPT)の説明
OpenAIは、OAI-SearchBotを、ChatGPTの検索の機能で、検索の結果にサイトを出すためのクローラーと説明しています。
そのうえで、検索の結果に出したいなら、robots.txtでOAI-SearchBotを許可するようすすめています。
止めたサイトは、ChatGPTの検索の答えには出ません。
ただし、サイトへの案内のリンクとしては出ることがある、とも書いています。
学習用のGPTBotを止めることは、学習に使わないでほしいという合図です。
robots.txtを直してから、検索に反映されるまで約24時間かかることがある、とも書かれています。
出典:OpenAI『Overview of OpenAI Crawlers』(2026年10月19日に確認・英語のページを要約)
Perplexityの説明
Perplexityは、PerplexityBotを、Perplexityの検索の結果にサイトを出し、リンクするためのクローラーと説明しています。
AIの基盤のモデルの学習のために集めるものではない、とも書いています。
検索の結果に出したいなら、robots.txtでPerplexityBotを許可するようすすめています。
変更が反映されるまでには、最大で24時間かかることがあります。
出典:Perplexity『Perplexity Crawlers』(2026年10月19日に確認・英語のページを要約)
利用者の操作で訪れるものは別
ChatGPT-UserとPerplexity-Userは、利用者の質問などで読みに来るもので、robots.txtが当てはまらないことがあります。
検索に出すかどうかを決めるのは、OAI-SearchBotとPerplexityBotの設定です。
Google:AIによる概要は検索と同じGooglebot
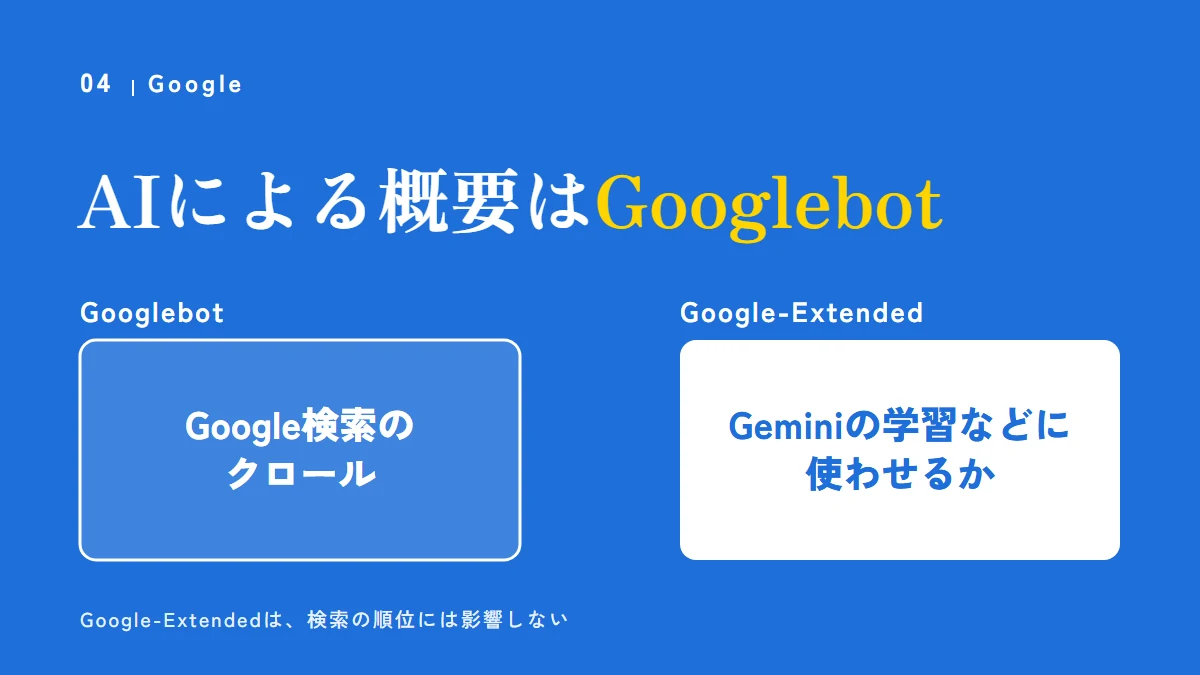
GoogleのAIによる概要やAIモードは、検索のためのGooglebotのクロールで管理します。
Google-Extendedは、Geminiの学習などに使わせるかを決める名前で、検索の順位には影響しません。
Googleの仕組みを知れば、検索ごと止めるまちがいを防げます。
「GoogleのAIだけ止めたい」と考えたことはありませんか。
Googleでは、検索とAIによる概要の土台が同じです。
AIによる概要は、Googlebotで管理する
Googleは、AI機能の説明のページで、検索用のクロールはGooglebotのrobots.txtの指定で管理する、と書いています。
AIによる概要やAIモードに表示されるための、追加の要件や特別な最適化はない、とも説明しています。
表示されるには、ページがインデックス(Googleが集めたページの目録)に登録され、スニペット(検索結果の説明の文)が表示されることなどが必要です。
ただし、インデックスに登録されても、表示は保証されません。
出典:Google 検索セントラル『AI 機能とウェブサイト』(2025年12月更新・2026年10月19日に確認)
Google-Extendedは、検索の順位に影響しない
Google-Extendedは、robots.txtに書く名前で、専用のクローラーはありません。
Googleは、Google-Extendedで、Geminiのモデルの学習や、Geminiアプリ・Vertex AIでのグラウンディング(答えの裏づけに中身を使うこと)に使わせるかを決められると説明しています。
さらに、Google-Extendedは、検索での登録やランキングには使われないと書いています。
出典:Google『Google の一般的なクローラー』(2026年9月更新・2026年10月19日に確認)

Google-Extendedを止めても、Google検索には影響しないんですね。
はい、Googleは、検索での登録やランキングには使われないと説明しています。
AIによる概要は、検索と同じGooglebotで管理します。
Copilot(Bing):ふつうの検索と同じ土台
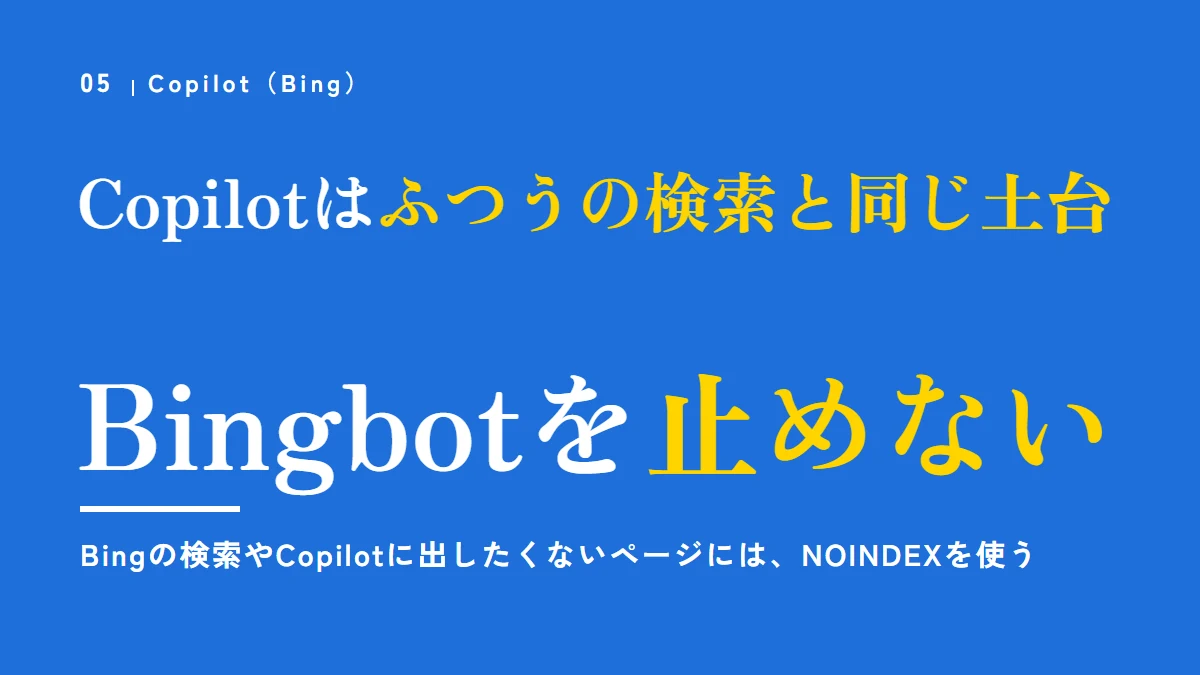
BingとCopilotの検索は、ふつうの検索と同じクロール・インデックス・順位付けの土台に立っています。
まず確かめるのは、robots.txtでBingbotを止めていないかです。
Bingの説明を知れば、Copilotだけの別の作業を探さずに済みます。
「Copilotは、Googleともまた違う仕組みなのでは」と気になりますよね。
Microsoftは、Bingのガイドラインで、SEOの基本はAIの答えにも当てはまると説明しています。
ガイドラインには、BingとCopilotの検索は、ふつうの検索と同じクロール・インデックス・順位付けの土台に立っている、と書かれています。
Bingのガイドラインにある、robots.txtの決まり
- robots.txtで、Bingbot(Bingのふだんのクローラー)を止めない
- robots.txtはクロールを決めるもので、インデックスを決めるものではない
- Bingの検索やCopilotに出したくないページには、NOINDEXを使う
- NOARCHIVEを使うと、Copilotの答えには使われない
Copilotに読んでほしいページで、Bingbotを止めていないかを確かめておきましょう。
出典:Microsoft『Bing Webmaster Guidelines』、『Which Crawlers Does Bing Use?』(2026年10月19日に確認・英語のページを要約)
Copilotで引用されたかを確かめる
Bing Webmaster Toolsの「AI Performance」では、Copilotなどの答えで、自社のどのページが引用されたかを見られます。
ただし、Microsoftは、SEOは順位を、AIの答えに向けた対策は引用を約束するものではない、とも書いています。
出典:Microsoft『AI Performance in Bing Webmaster Tools』、『Bing Webmaster Guidelines』(2026年10月19日に確認・英語のページを要約)
robots.txtの確かめ方と書き方の例
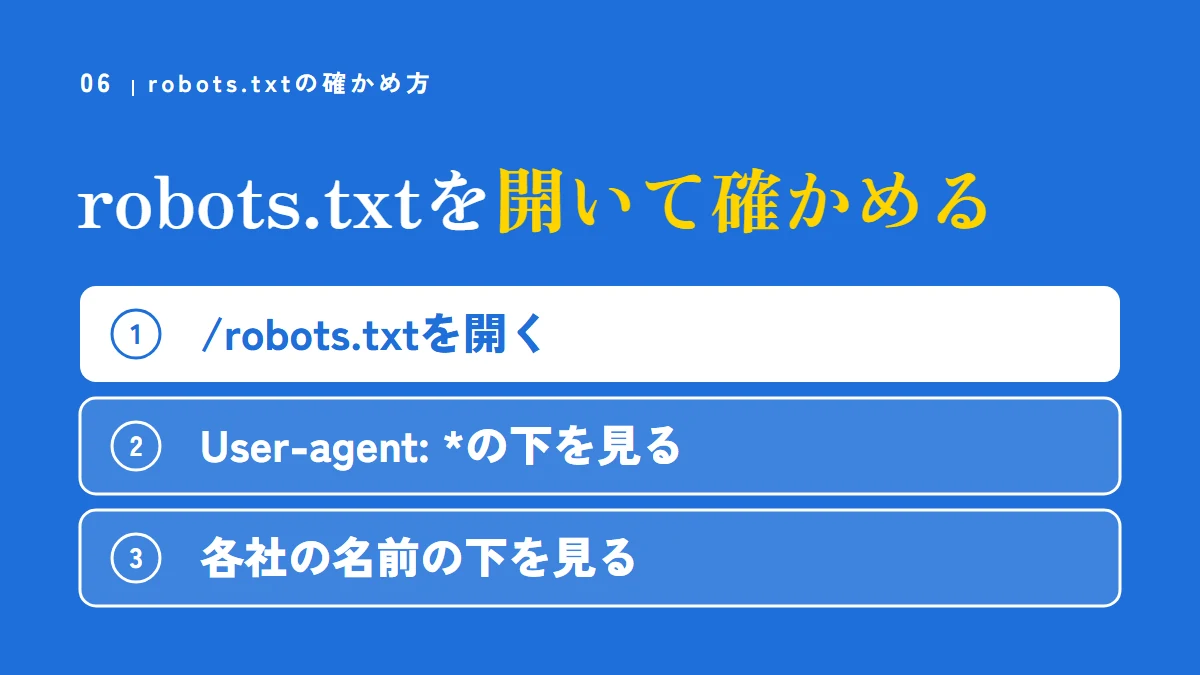
ブラウザで「https://自社のドメイン/robots.txt」を開けば、今の設定を確かめられます。
書き方は、User-agentの行でクローラーを選び、Disallow・Allowの行で読んでよい所を決めます。
確かめ方が分かれば、今日中に自社の設定を見られます。
「robots.txtなんて、触ったことがない」と不安になりますよね。
見るだけなら、ブラウザで開くだけです。
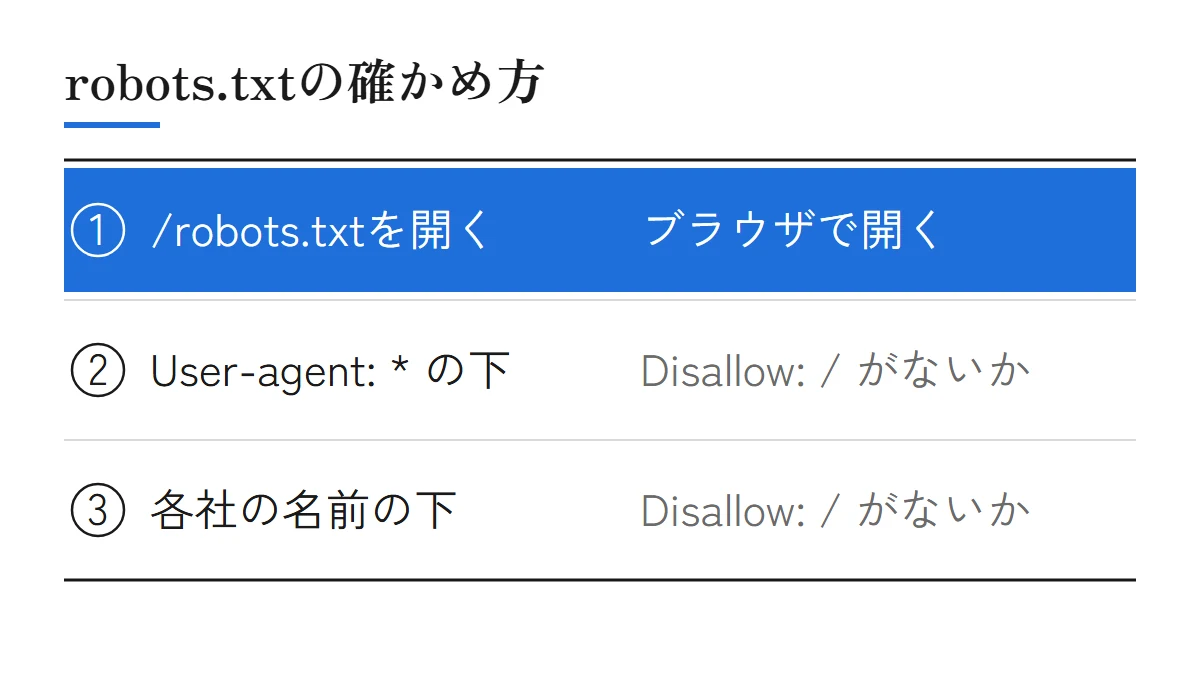
手順:開いて、名前の下を見る
- ブラウザで「https://自社のドメイン/robots.txt」を開く
- 「User-agent: *」の下に「Disallow: /」がないかを見る
- OAI-SearchBot・PerplexityBot・Googlebot・Bingbotの名前の下に「Disallow: /」がないかを見る
Googleは、robots.txtで特に指定しない限り、すべてのファイルはクロールを許可されていると説明しています。
書き方の例(Googleの公式の例)
Googleは、2つのルールを含む簡単な例として、次の形を出しています。
User-agent: Googlebot
Disallow: /nogooglebot/

User-agent: *
Allow: /

Sitemap: https://www.example.com/sitemap.xml
この例の意味は、次のとおりです。
- Googlebotには、「/nogooglebot/」で始まるURLを読まないように伝える
- ほかのクローラーには、サイト全体を読んでよいと伝える(書かなくても同じ)
- サイトマップの場所を伝える
出典:Google『robots.txt の書き方、設定と送信』(2025年11月更新・2026年10月19日に確認)
クローラーを名前で分けて指定するとき
User-agentの行には、各社が公表しているクローラーの名前を書きます。
同じ名前のグループの中に、Disallow(読まない所)とAllow(読んでよい所)を並べます。
たとえば、Google-Extendedについて、Googleは次の例を出しています。
user-agent: Google-Extended
allow: /archive/1Q84
disallow: /archive/
この例は、「/archive/」の下は使わせず、「/archive/1Q84」だけは使ってよい、という指定です。
直したら、確かめる
Googleは、シークレット ウィンドウで開いて見る方法と、Search Consoleのrobots.txtレポートを案内しています。
反映まで24時間ほどかかることがあるので、直した翌日にもう一度見ます。
自分でrobots.txtを開いたら、Disallowの行がたくさんありました。
まずは「Disallow: /」だけの行が、どのUser-agentの下にあるかを見ます。
分からないときは、ホームページを作った会社に確かめてもらいましょう。
注意:robots.txtで気をつけること
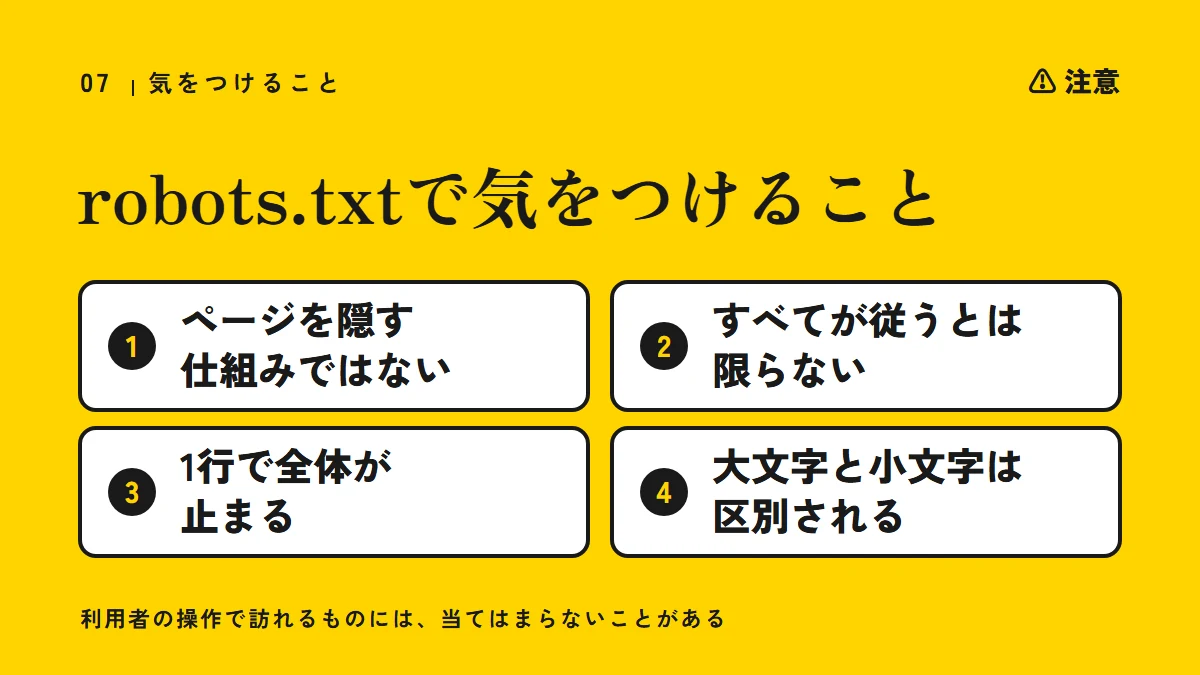
robots.txtは、ページを隠す仕組みではなく、すべてのクローラーが従うとも限りません。
1行のまちがいで、サイト全体を止めてしまうこともあります。
気をつけることを知れば、止めたつもり・出したつもりを防げます。
「robots.txtに書けば、もう安心」と思っていませんか。
Googleは、robots.txtの指示に従うかどうかはクローラー次第だと説明しています。
- ページを隠す仕組みではない:隠したいページにはnoindexやパスワードを使う
- すべてが従うとは限らない:Googlebotは従うが、ほかも従うとは限らない
- 利用者の操作で訪れるものは別:robots.txtが当てはまらないことがある
- 1行で全体が止まる:「User-agent: *」の下の「Disallow: /」
- 大文字と小文字は区別される:「/file.asp」と「/FILE.asp」は別
止めたURLが、検索の結果に出ることもある
Googleは、robots.txtで止めたURLでも、ほかのサイトからリンクされていれば、検索の結果に出ることがあると説明しています。
そのため、出したくないページは、robots.txtではなくnoindexで指定します。
出典:Google 検索セントラル『robots.txt の概要とガイド』(2025年12月更新・2026年10月19日に確認)
「AIのクローラーは全部止めればいい」という考えへの答え
「AIのクローラーは全部止めてしまおう」という考えもあります。
たしかに、学習に使われたくないなら、GPTBotやGoogle-Extendedを止める選び方があります。
ただし、OAI-SearchBotを止めると、ChatGPTの検索の答えには出ません。
止める前に、何のためのクローラーかを確かめましょう。
クローラーの次にやること:土台は正しいSEO
LLMO対策は、特別なことではありません。
クローラーを止めていないことを確かめたら、あとは正しいSEOを続けます。
土台から整えれば、ムダな対策に時間を使いません。
「クローラーを通したら、次は何をすればいいの」と思いますよね。
LLMO対策(AIの答えを意識した対策)も、クローラーを通したあとは検索のための基本と同じです。
Googleは、AIによる概要やAIモードのために、特別な最適化は要らないと説明しています。
Microsoftも、SEOのやり方が、CopilotなどのAIの答えや引用の対象になることを支える、としています。
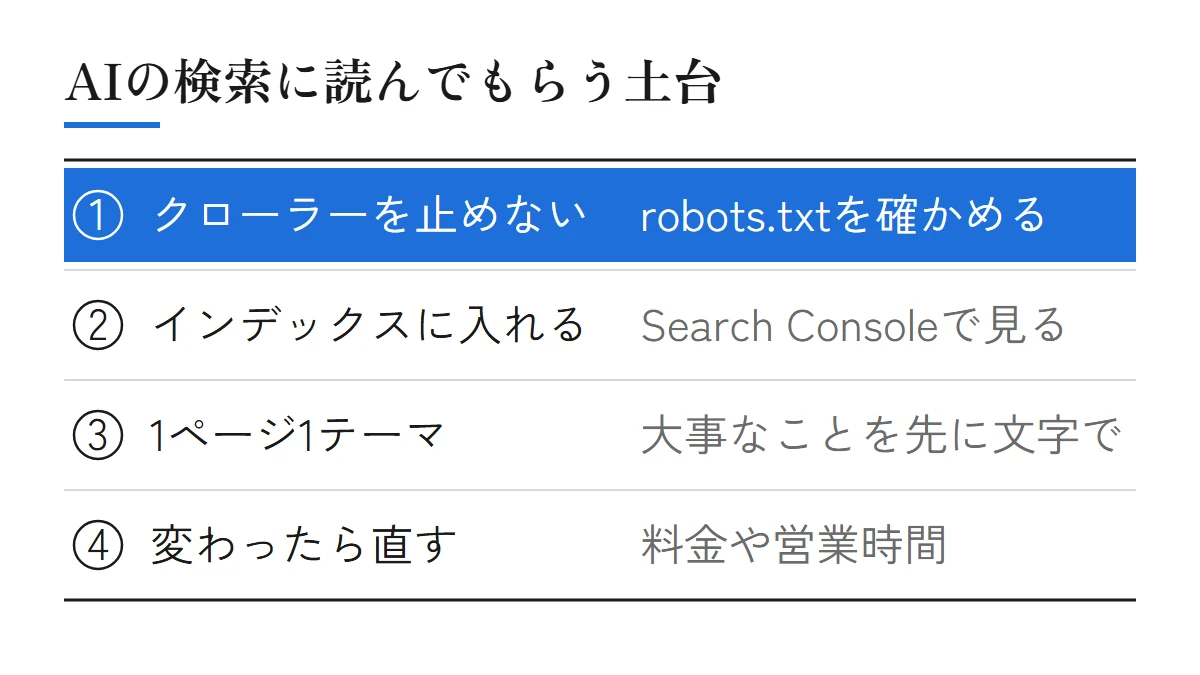
土台としてやること
- robots.txtで、検索用のクローラーを止めていないかを確かめる
- Search Consoleで、ページがGoogleのインデックスに入っているかを確かめる
- 1つのページで1つのテーマを扱い、大事なことを先に文字で書く
- 料金や営業時間が変わったら、すぐにページを直す
SEOの基本は「SEO対策とは」、自分で始める手順は「SEO対策は自分でできる?」にまとめました。
LLMO対策の全体は「LLMO対策とは」、AIによる概要の条件は「AI Overviewとは」にあります。
llms.txtは「llms.txtとは」、構造化データは「構造化データとは」で説明しています。
当社でできること
当社のホームページ制作は200,000円〜(税込)で、載せる内容を決めて文章を書くところから、検索で見つかる設計、制作・公開までを含みます。
SEO記事は1本10,000円(税込)で、検索キーワードの調査・執筆と、画像の作成・掲載を含みます。
どちらを使っても、AIの答えに出ることはお約束できません。
くわしくはサービスと料金のページにまとめています。
AIのための特別な作業より、まずは土台なんですね。
はい、お客さんが知りたいことに答えるページを、1本ずつ足していきましょう。
よくある質問
何も書いていない場合、GPTBotを止めた場合、Google-Extendedと順位、反映までの時間。
よく聞かれる4つに答えます。
答えを知っておけば、次に何をするかが決まります。
ここまで読んで、まだ気になる点が残っていませんか。
robots.txtに何も書いていなければ、止めていないことになりますか
Googleの説明では、特に指定しない限り、クロールは許可されています。
そのため、書いていなければ、止めていません。
GPTBotを止めると、ChatGPTの検索に出なくなりますか
いいえ、OpenAIは、OAI-SearchBotを許可したまま、GPTBotだけを止められると説明しています。
検索に出るかどうかに関わるのは、OAI-SearchBotの設定です。
Google-Extendedを止めると、Google検索の順位は下がりますか
Googleは、Google-Extendedは検索での登録に影響せず、ランキングのシグナルとしても使われない、と説明しています。
AIによる概要などの検索の機能は、Googlebotで管理します。
robots.txtを直したら、すぐに反映されますか
OpenAIは約24時間、Perplexityは最大24時間かかることがある、と書いています。
直した翌日に、もう一度確かめましょう。
まとめ:検索用のクローラーを止めず、土台のSEOを続ける
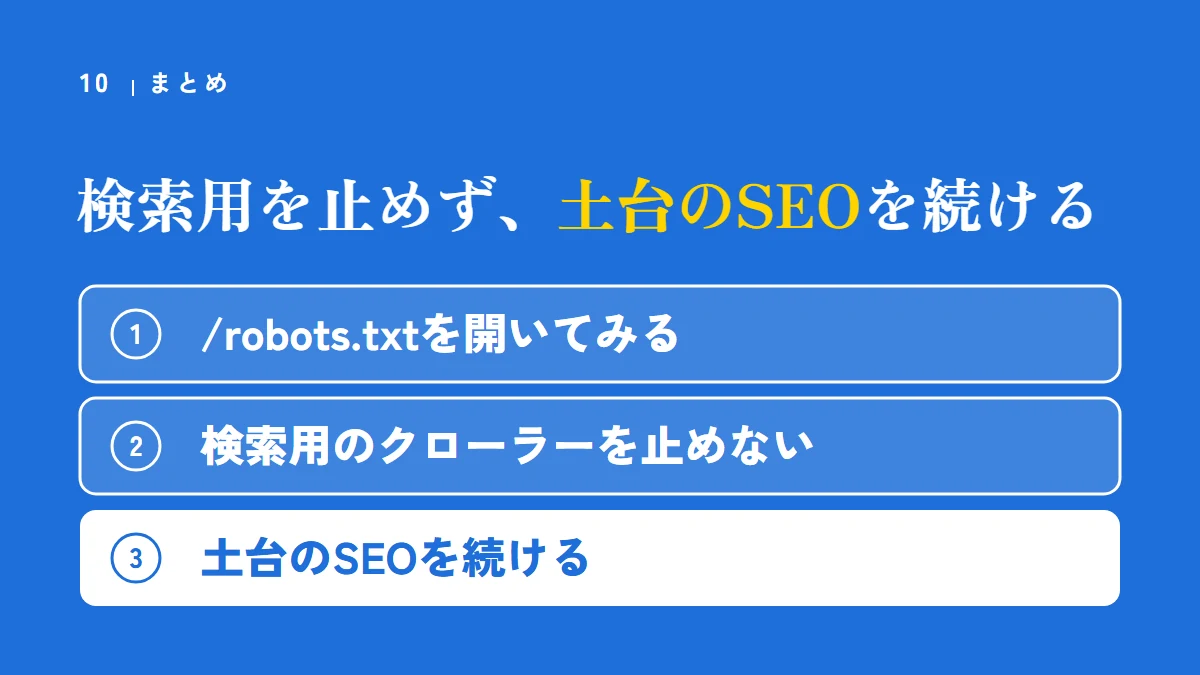
AIのクローラーには、検索用・学習用・利用者の操作で訪れるものがあり、役目で分けて考えます。
検索に出したいなら検索用を止めず、そのうえで土台のSEOを続けます。
さいごに、要点をふり返ります。
- ChatGPTはOAI-SearchBot、PerplexityはPerplexityBotを止めない。
GPTBotなどの学習用は、別に決められる - GoogleのAIによる概要はGooglebot、CopilotはBingbotのクロールが土台。
Google-Extendedは検索の順位に影響しない - robots.txtはページを隠す仕組みではない。
出したくないページはnoindexで指定する
今日できるのは、自社のサイトで「/robots.txt」を開いてみることです。
そのうえで、土台のSEOを続けます。
ホームページの今の状態を確かめたいときは、お問い合わせフォームからご連絡ください。
ご相談からお見積りまでは無料です。
アプリコットフィルムは、SEO対策とLLMO対策を別料金にせず、最初から両方を意識してホームページと記事をつくります。